Änderungs- und Überarbeitungsprozesse innerhalb eines Dokuments
Änderungen jeglicher Art werden dem textgenetischen Modell dieser Edition entsprechend in ihrer Relation zum vorherigen Textzustand bzw. zur vorherigen Textschicht, sofern differenzierbar, ausgezeichnet und wiedergegeben. Dies gilt sowohl für den Text im engeren Sinne als auch für metatextuelle Anmerkungen und alle weiteren erfassten und dargestellten Zeichen.
Einzelne Überarbeitungen wie Streichungen, Hinzufügungen oder Ersetzungen werden über das Attribut @change den genannten Textschichten zugeordnet – während unmittelbare Änderungen wie Sofortkorrekturen implizit durch Auslassung des Attributs der jeweils ersten Textschicht zugeordnet werden. Sollte anhand des handschriftlichen Befunds keine eindeutige Differenzierung möglich sein, die beispielsweise mithilfe des Schreibgerätes oder auch des Schriftduktus eindeutig voneinander zu scheiden ist, werden alle Änderungen sowie der Textbestand der eigentlichen Grundschicht zu einer Schicht zusammengefasst. Auch hier wird auf die explizite Vergabe des Attributs @change verzichtet.
Tilgungen
Als Tilgungen gelten
Durchstreichungen einzelner oder mehrerer Zeichen, Wörter oder Zeilen.
Überschreibungen einzelner oder mehrerer Zeichen oder Wörter.
intendierte Streichung durch vorgenommene Ergänzungen zur jeweiligen Stelle.
Durchstreichungen in Kombination mit Ersetzungen einzelner Zeichen, Wörter oder Zeilen.
Die Erfassung in den TEI-Daten erfolgt traditionell durch das Element <del>. Die beiden Attribute @type und @hand spezifizieren einerseits die Art der ausgeführten Streichung, entsprechend der zuvor angeführten Auflistung, und verweisen andererseits auf die materielle Ausführung. Streichungen ganzer Zeilen oder auch Strophen werden abweichend hiervon durch den kombinierten Einsatz von <delSpan/> und <anchor/> (leeres Element) ausgezeichnet.
Die Darstellung von Streichungen erfolgt durch die Anzeige eines horizontalen Strichs. Die genaue grafische Ausführung kann dem beigegebenen Faksimile entnommen werden. Jede Tilgung ist über das @change-Attribut einem Textzustand zugeordnet. Ist in der Einzelansicht eines Dokuments dieser Textzustand ausgewählt, werden hier zugeordnete Streichungen durch rote Hintergrundfarbe hervorgehoben. In nachfolgenden Textzuständen werden sie ohne Hervorhebung als gestrichen dargestellt.
Getilgter und wiederhergestellter Text, z. B. durch entsprechende Anmerkungen, wird durch eine gelbe Hintergrundfarbe hervorgehoben.
Hinzufügungen
Ergänzte Graphen oder auch Wörter werden einzeln erfasst und in der Ausgabe im jeweiligen Textzustand durch grüne Hintergrundfarbe hervorgehoben. Ergänzungen innerhalb eines Segments werden mit dem Element <add> ausgezeichnet, Hinzufügungen eines oder mehrerer Segmente durch <addSpan/>. Die gleichen Attribute wie bei einer Streichung können verwendet werden, mit Ausnahme von @type; stattdessen wird hier über @place der Ort der Hinzufügung in Korrelation zur Basiszeile angegeben.
Umstellungen
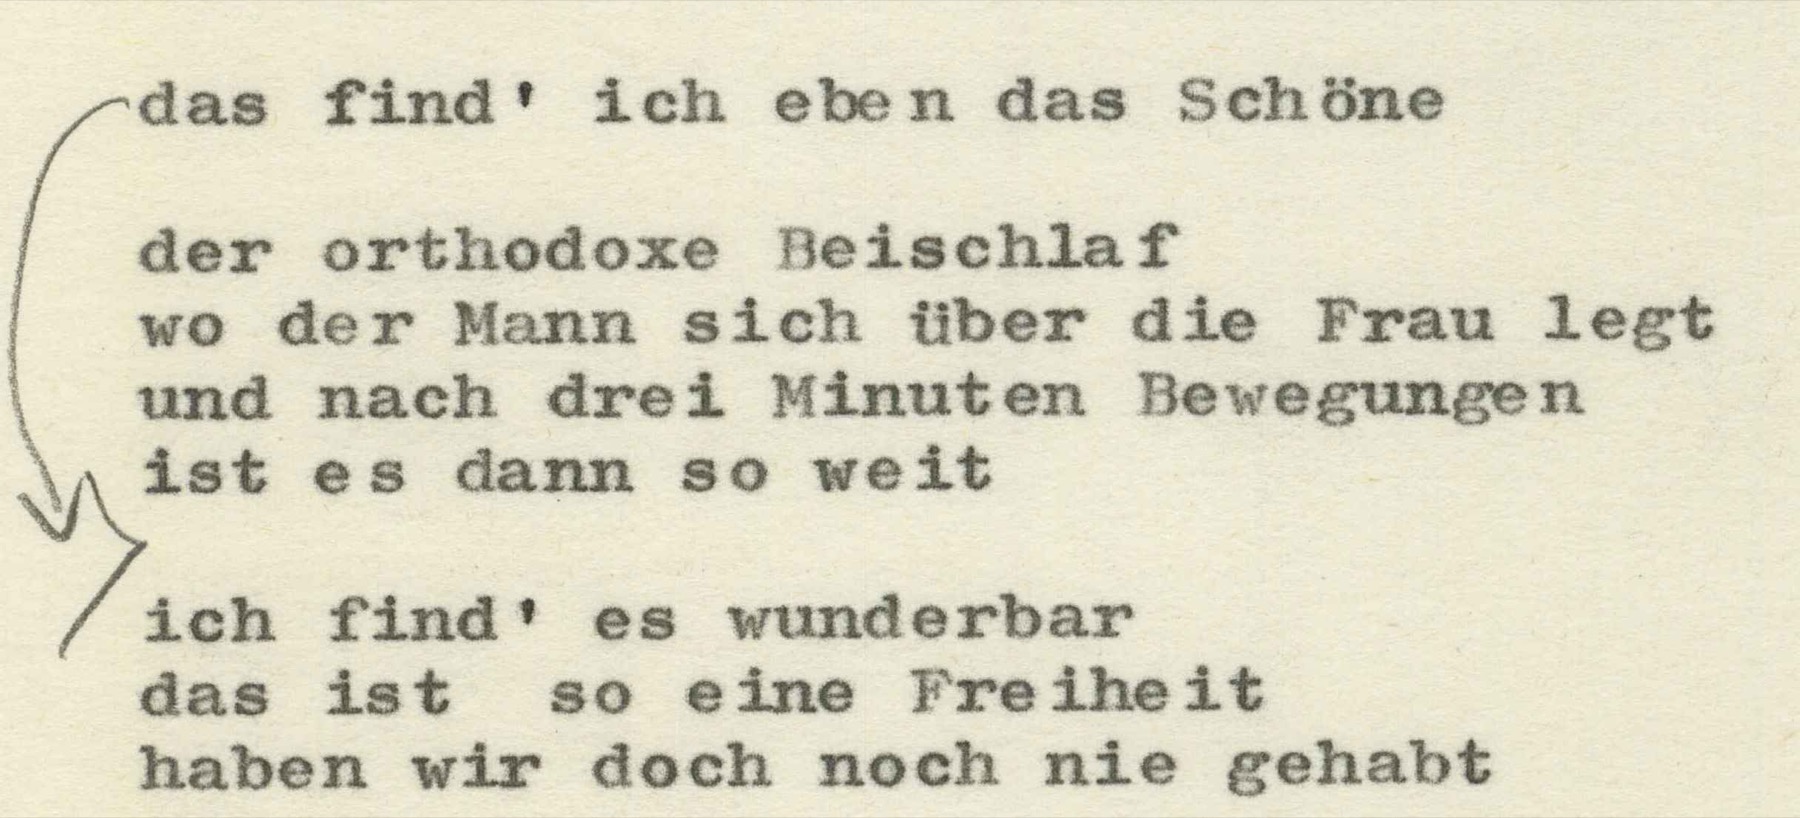
Umstellungen einzelner Zeichen, Wörter oder auch ganzer Zeilen werden in der Dokumenteinzelansicht durch blaue Hintergrundfarbe im jeweiligen Textzustand hervorgehoben. Die korrespondierende Stelle wird bei Mouseover durch gelbe Hintergrundfarbe angezeigt.
Unterstreichungen und Einrahmungen
In den Vorarbeiten zu So eine Freiheit finden sich nicht nur die zuvor beschriebenen Ergänzungen, Streichungen oder Ersetzungen, sondern ebenso verschiedene Formen grafischer Markierungen wie Unterstreichungen oder Einrahmungen. Der Autor markiert hiermit sowohl einzelne Wörter als auch ganze Absätze. Wie die zuerst genannten (typischen) Änderungsformen bezeugen, stellen diese ein „Protokoll der Schwierigkeiten, die der Übergang von einem medialen Zustand zu einem anderen bereitet“, dar und dokumentieren den Prozess der Textentstehung. Sie verknüpfen zugleich verschiedene Bestandteile im Netzwerk des Dokumentkorpus miteinander.
Die Wiedergabe in der digitalen Edition orientiert sich an folgenden Prinzipien:
Unterstreichungen werden unabhängig von ihrer konkreten Ausführung als einfache Unterstreichung wiedergegeben. Die Ausführung der Unterstreichung im Original ist als Annotation hinterlegt.
Einrahmungen einzelner Wörter oder auch ganzer Textabschnitte werden nicht wiedergegeben und auch nicht in der Annotation erfasst.
Letztgültiger Textzustand
Der letztgültige Textzustand oder auch Endzustand bildet die Summe aller vorherigen Textzustände je Seite eines Manuskripts oder Typoskripts und stellt das Ergebnis aller Änderungsprozesse dar. Getilgte Textbestandteile sowie metatextuelle Anmerkungen werden nicht mehr angezeigt. Der Zeilenfall wird weiterhin so wiedergegeben, wie er im Dokument erscheint.
Dokument- und fassungsübergreifende Änderungen und Relationen
Die in den vorangehenden Abschnitten dargelegten Möglichkeiten des editionsspezifischen TEI-Schemas und das daraus abgeleitete Datenmodell erlauben eine präzise Auszeichnung verschiedener textgenetischer Phänomene – diese bleibt dabei jedoch stets beschränkt auf den einzelnen Textträger. Zur Untersuchung (und späteren Aufbereitung für die Nutzenden) der textgenetischen Verhältnisse zwischen den einzelnen Dokumenten und den hieraus zu konstituierenden Fassungen bedarf es weiterer Annotationen, die über die Grenzen der einzelnen Dokumente hinausgehen. Die TEI-Arbeitsgruppe für genetische Editionen hat dafür eine Differenzierung zwischen dem document level und dem dossier level vorgeschlagen.1 Die Dokumentebene bezeichnet dabei all jene Auszeichnungen innerhalb eines einzelnen <TEI>-Dokuments. Wohingegen ein Dossier, in Anlehnung an die Begriffsbildung der critique génétique, ein „set of documents which a genetic editor considers as having contributed to the evolution of a particular text“ beschreibt, womit ein Wechsel auf die Ebene der Fassung und des Werks implizit mitgedacht wird.2 Die Autor*innen schlagen zur Auszeichnung entweder die Erstellung sog. <teiCorpus>-Dokumente vor, die einzelne Dokumente integrieren, oder die darstellungsorientierte Auszeichnung mithilfe der Elemente <graph>, <node> und <arc>. Für den tatsächlichen Textvergleich sind diese Informationen dann mit einer einzelstellenbasierten Erstellung von Apparaten (<app> und <rdg>) zu kombinieren.3
Für die hier konzipierte Edition des Werkkomplexes So eine Freiheit wird dem Vorschlag der Arbeitsgruppe nicht gefolgt.4 Stattdessen soll hier ein logisches Modell vorgeschlagen werden, welches im Gegensatz zur häufig anzutreffenden Praxis kein proprietäres XML-Datenformat einführt noch zusätzliche Technologien zur Erfassung dieser Informationen verwendet, sondern auf den bereits vorhandenen Möglichkeiten der TEI-Richtlinien aufbaut.5 Die vorgeschlagene Lösung ist nicht nur auf die Edition des Werkkomplexes So eine Freiheit beschränkt, sondern kann auch auf andere Anwendungsfälle übertragen werden.
Neben den von der Textgenesearbeitsgruppe der TEI vorgeschlagenen Möglichkeiten bieten die TEI-Richtlinien selbst noch verschiedene Elemente an, die sich zur Verknüpfung – und damit zur Herstellung verschiedener Relationen – zwischen einzelnen TEI-Datensätzen eignen: Dafür werden in Kapitel 16 der ‚Richtlinien‘ u. a. die Elemente <linkGrp> und <link> eingeführt. Mit einem <link> besteht in TEI-XML die Möglichkeit, die Zusammengehörigkeit verschiedener Abschnitte oder Elemente auszudrücken. Ein solcher Verweis kann dabei entweder ähnlich wie ein Hyperlink im Web oder auch als semantische Verknüpfung verstanden werden. Die über das Attribut @target referenzierten Dokumentfragmente müssen dabei nicht zwingend geordnet sein und im Unterschied zu Hyperlinks kann ein solcher Link mehr als ein bzw. zwei Angaben enthalten.6 Ergänzend zur Erfassung von Relationen zwischen einzelnen Abschnitten oder ganzen Dokumenten mithilfe von Links erlauben die <linkGrp>s, zusammengehörige Verweise zu bündeln und gleichzeitig weitere Informationen zur Art des Links (@type) sowie zur Anordnung der Werte im @target-Attribut anzugeben.7
Die Anwendung des Datenmodells wird nachfolgend am Beispiel der rekonstruierten textgenetischen Beziehungen der 19. Figuration illustriert. Dabei wird zwischen drei verschiedenen Typen von Verbindungen unterschieden:
Ein Dokument wird aus einem oder mehreren Dokumenten figuriert (
type = 'isFigurationOf').Ein Dokument ist eine Überarbeitung eines oder mehrerer Dokumente (
type = 'isRevisionOf').Ein Dokument ist die Veröffentlichung eines oder mehrerer Dokumente (
type = 'isPublicationOf').
Mithilfe der beiden Elemente <link> und <linkGrp> lassen sich so die textgenetischen Beziehungen zwischen einzelnen Dokumenten, die der Genese einer Figuration zugeordnet werden können, in XML modellieren. Die Referenz ist dabei stets das einzelne Dokument, auf das über die eindeutig vergebene xml:id verwiesen wird.
Diese Informationsmodellierung ermöglicht zunächst die Erfassung von Beziehungen auf der (textgenetischen) Ebene der Fassungen bzw. der Dokumente, aus denen sie konstituiert wird. Darüber hinausgehend bedarf es für den konkreten Vergleich der einzelnen Fassungstexte (siehe Anforderungen in Abschnitt 4.3 (Stand 27.10.2026)) noch der Erstellung kritischer Apparate, die einzelne Textsegmente miteinander in Beziehung setzen. Die Modellierung und halbautomatische Erstellung dieser Apparate wird in Abschnitt 7.3.1 näher erläutert.
Vgl. Genetic Edition Working Group: An Encoding Model for Genetic Editions.↩︎
Genetic Edition Working Group: An Encoding Model for Genetic Editions.↩︎
Die Möglichkeiten zur Erstellung eines kritischen Apparats werden hier nicht näher erläutert. Für Details siehe diese ausführlichen Erläuterungen in den TEI-Richtlinien: TEI Consortium: TEI P5. Guidelines for Electronic Text Encoding and Interchange. timeline.↩︎
In der Praxis hat sich gezeigt, dass es bisher kein standardisiertes Datenmodell zur Erfassung textgenetischer Phänomene zwischen Dokumenten gibt. Siehe hierzu die Erläuterungen in Abschnitt 4.3 (Stand 27.10.2026).↩︎
So definiert bspw. die Faustedition eigene XML-Elemente. Vgl. faust-xml. Alessio Christen und Elena Spadini schlagen für die genetische Edition von Gustav Roud hingegen einen Ansatz basierend auf Technologien des Semantic Web vor. Vgl. Christen und Spadini: Modeling Genetic Networks. Gustave Roud’s Œuvre, from Diary to Poetry Collections.↩︎
Ein Hyperlink (
<a>) in HTML geht zwingenderweise immer von einer Quelle aus und zeigt auf genau ein Ziel. Es besteht also stets eine 1:1-Beziehung. Ein<link>in TEI kann, muss aber nicht ebenso funktionieren, wobei Quelle und Ziel explizit im Attribut@targetangegeben werden. Hierüber lassen sich 1:1-Beziehungen ebenso wie 1:n-Beziehungen gleichermaßen abbilden. Das TEI-Linkkonzept funktioniert auf der Ebene der Beschreibung ähnlich wie die sog. XLinks, ohne jedoch Details zur Auflösung dieser Angaben vorzugeben. Vgl. TEI Consortium: TEI P5. Guidelines for Electronic Text Encoding and Interchange. 8 Transcription of Speech; W3C: HTML. Living Standard. 4.6 Links sowie W3C: XML Linking Language (XLink) Version 1.1.↩︎Vgl. TEI Consortium: TEI P5. Guidelines for Electronic Text Encoding and Interchange. hi.↩︎