Projektspezifisches Schema
Die Richtlinien der TEI bieten aufgeteilt auf 23 Module ein reichhaltiges Vokabular zur Kodierung verschiedener textueller Phänomene. Dies geht mit einer Offenheit in der Verwendung der zur Verfügung stehenden Auszeichnungsmöglichkeiten einher, welcher „durch projektspezifische Restriktionen in Form von Schemaanpassungen – einer sogenannten TEI-Customization – entgegenzuwirken, deren Einrichtung von der TEI dringend empfohlen wird“.1 Diese Auswahl und Anpassung der TEI-Richtlinien geschieht in der TEI-eigenen Dokumentationssprache ODD. Diese Dokumentation legt Regeln fest, die bestimmen, welche Module und damit welche XML-Tags innerhalb des Projekts verwendet werden, welche Attribute für die jeweiligen Elemente erlaubt sind und ob es kontextspezifische Einschränkungen zur Nutzung gibt. Das Auszeichnungsmodell der digitalen Wühr-Edition wird im ODD-Format bereitgestellt, auf dessen Basis weitere Schemadateien erzeugt werden.
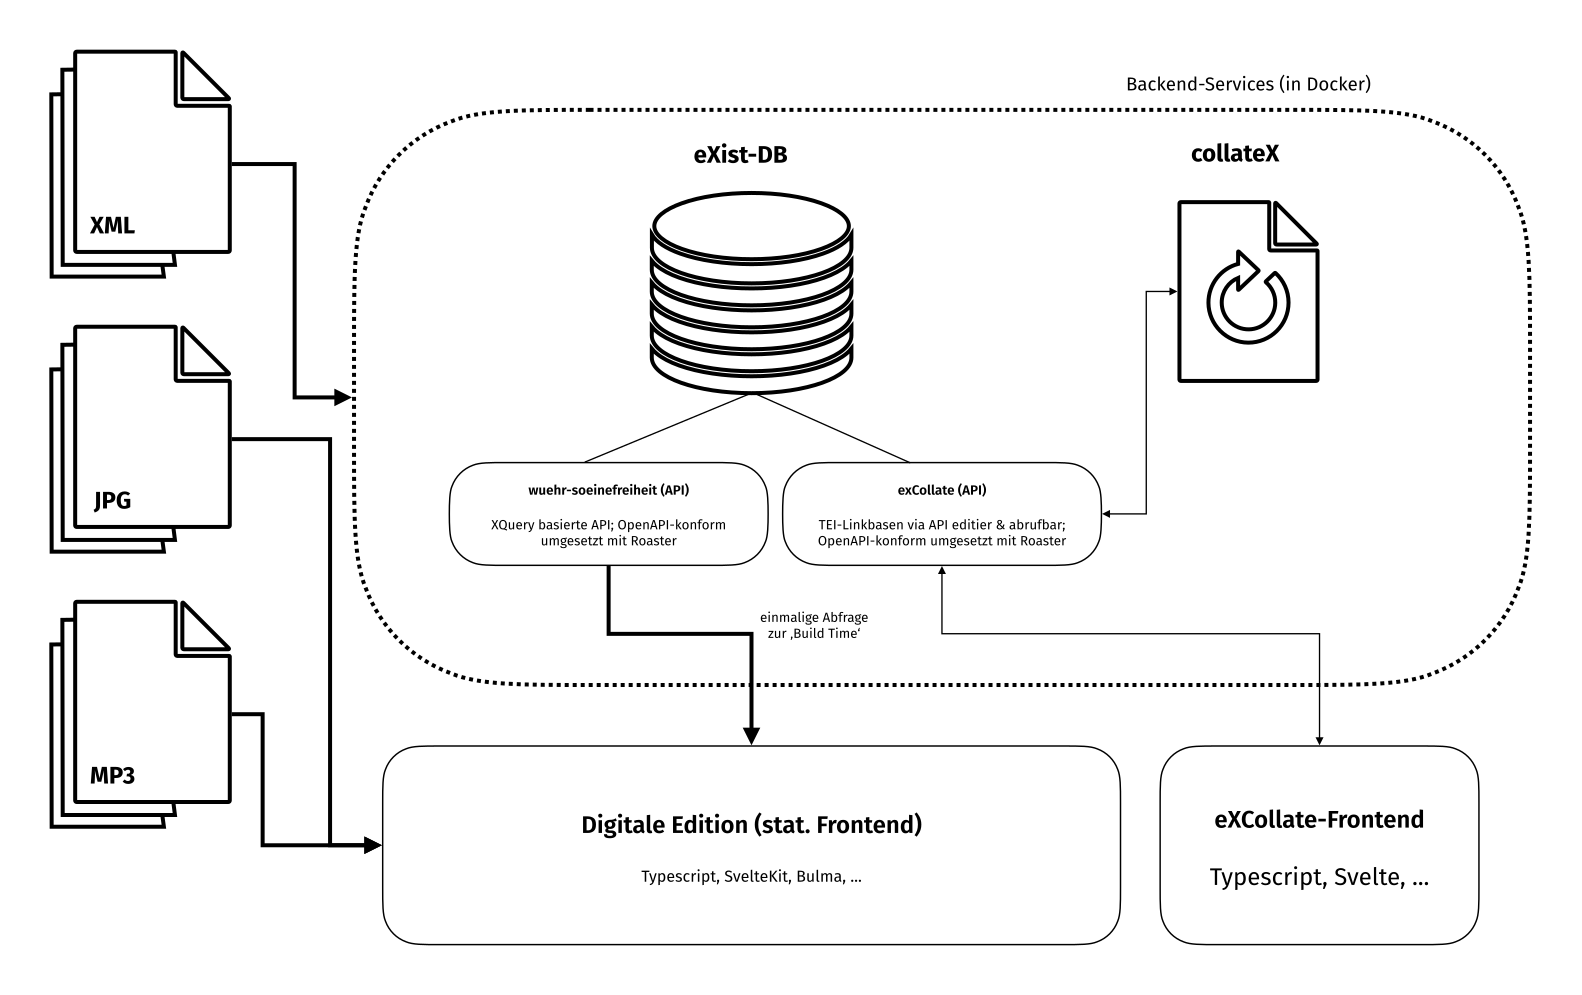
Stattdessen wird auf eine Kombination verschiedener Softwarepakete zurückgegriffen. Der grundlegende Aufbau ist in Abbildung 7.1 dargestellt und setzt sich im Wesentlichen aus einer Arbeitsumgebung sowie der statisch generierten Präsentationsschicht zusammen. Dabei kommt neben dem sog. X-Stack (XML, XPath, XSLT und XQuery – gespeichert und ausgeführt in eXist-DB) insbesondere das JavaScript-Framework Svelte(Kit) zum Einsatz, welches die Generierung der statischen Präsentationsschicht übernimmt.2
Vorbemerkung zur halbautomatischen Kollationierung verschiedener Textfassungen
Technische Umsetzung
Die Kollationsumgebung basiert auf einer ähnlichen Architektur wie die digitale Edition und ist Teil der Arbeitsumgebung (siehe dazu Abbildung 7.1). Analog zum Gothenburg Model ist der Prozess des Textvergleichs in sechs Teilschritte aufgeteilt. So wird in einem ersten Schritt zunächst der Text der miteinander zu vergleichenden Dokumente zeilenweise ausgelesen (Code 7.4:2). Dieser wird dabei normalisiert bzw. reduziert, so wird in diesem Schritt u. a. der gestrichene Text einer Ersetzung entfernt; außerdem werden Sonderzeichen wie Doppelpunkte oder Kommata, die das Ergebnis eines automatischen Vergleichs ungewollt negativ beeinflussen, ebenfalls (temporär) getilgt. Dieser extrahierte Text wird dann in einem zweiten Verarbeitungsschritt als Grundlage für eine automatische Alignierung, also eine Zuordnung, der Zeilen verwendet. Der Algorithmus, der hierfür verwendet wird, generiert passende Paare von Zeilen mithilfe von Volltextindices der eXist-Datenbank (Code 7.4:6-11). Für jede Zeile wird eine Volltextsuche in den Quelldokumenten der anderen Fassungen durchgeführt. Dieses Suchergebnis generiert eine Liste von Kandidaten – derjenige mit der höchsten Übereinstimmung wird als korrespondierende Zeile ausgewählt und als <link> gespeichert.3
declare function colhelper:create-links($filename as xs:string, $cleanedXml as node()*, $context as map(), $docs as array(*)) {
        for $line in $cleanedXml//tei:l
        let $linkId := $context?witness || '-' || $line/@xml:id/data(.)
        let $collation := doc($config:app-root || '/data/' || $filename)
        let $expression := $line//text() => string-join('') => normalize-space() => replace('[:\+\-,\*]+', '')
        let $possibleMatches :=
            if ($collation//tei:link[contains(@synch, ('#' || $linkId))] => exists())
            then
                let $matchingLink := $collation//tei:link[contains(@synch, ('#' || $linkId))][1]
                return ($matchingLink/@synch => replace(('#' || $linkId), '#' || $matchingLink/@xml:id))
            else
                colhelper:find-matches($expression, colhelper:filter-array-by-key-value($docs, 'witness', $context?witness))
        let $linkTemplate :=
            element link {
                attribute {'xml:id'} {$linkId},
                attribute {'corresp'} {concat('#', $line/@xml:id/data(.))},
                attribute {'source'} {concat('#', $context?document)},
                if ($possibleMatches => normalize-space() => string-length() gt 0)
                then
                    (attribute {'synch'} {$possibleMatches => functx:trim() => normalize-space()})
                else ()
            }
        return
            update insert $linkTemplate into $collation//tei:standOff//tei:linkGrp[@corresp = '#' || $context?witness ]
};
Das Ergebnis dieses Textvergleichs auf Segmentebene wird im nächsten Schritt der editorischen Instanz in einer grafischen Oberfläche präsentiert. Hier können Ergänzungen und Korrekturen vorgenommen werden. Die Daten werden stets in der verwendeten XML-Datenbank aktualisiert und gespeichert. Abschließend werden die einzelnen Zeilen unter Verwendung von CollateX automatisiert miteinander verglichen. Hierfür wird der Text der zuvor parallelisierten Segmente erneut aus den ursprünglichen Quelldokumenten extrahiert, anschließend normalisiert und in einzelne Tokens (hier Wörter) unterteilt.4 Die so erzeugten Tokens werden dann von CollateX miteinander verglichen, und die Ergebnisse werden anschließend als Apparate (<app>) in das Kollationsdokument eingefügt. Dabei ist sichergestellt, dass die Referenz auf die ursprünglichen Textsegmente und -zeugen stets erhalten bleibt (siehe oben); zudem besteht hier, da die Implementierung einfachen Prinzipien folgt, ein hohes Maß an Nachvollziehbarkeit und Reproduzierbarkeit der Ergebnisse.
Aufbau und Funktionalität der REST-API
Die REST-API, die vom Backend der digitalen Editionsumgebung bereitgestellt wird, nicht zu verwechseln mit der statisch generierten HTML-Ausgabe der digitalen Edition, ist in vier Bereiche unterteilt:
/api/text– Auflistung der veröffentlichten Figurationen sowie HTML-Ausgabe pro Figuration./api/documents– Auflistung aller Dokumente mit ihren Metadaten sowie HTML-Ausgabe pro Dokument./api/apparatus– Auflistung der verfügbaren ‚Apparate‘ sowie HTML-Ausgabe pro Figuration./api/search/index– Liste von extrahierten Textstellen aus allen<l>und<annotationBlock>Elementen. Wird vom Frontend für die Suche verwendet.
Die zugrundeliegende Logik ist in den gleichnamigen XQuery-Modulen unter ./modules/api implementiert.
Dokumentation einzelner Komponenten
<Audiodisplay>
Quelldatei:
src/lib/components/Audiodisplay.svelteBeschreibung: Hauptkomponente zur Darstellung der Ansicht des Hörtextes. Bindet die Komponenten
<Partiture>und<Peaks>ein.Sonstiges: Wird im UI die Druckfassung ausgewählt, dann wird die Komponente automatisch ausgeblendet. Dafür stellt diese die Property
showzur Verfügung, die von einer Elternkomponente gesteuert werden kann.
<CiteSuggestion>
Quelldatei:
src/lib/components/CiteSuggestion.svelteBeschreibung: Hauptkomponente zur Erzeugung eines automatisierten Zitiervorschlags. Erzeugt basierend auf der URL sowie dem aktuellen Datum einen Zitiervorschlag, der die URL der digitalen Edition sowie einen menschenlesbaren Titel enthält. Berücksichtigt alle URL-Parameter, sodass ein spezifischer Zustand bei erneutem Aufruf der Seite reproduziert werden kann.
Dokumentarchiv
Quelldatei:
src/routes/dokumente/+page.svelteBeschreibung: Komponente, die die HTML-Seite des Dokumentarchivs darstellt. Bindet funktionale Komponenten ein, die die Anzeige der Dokumente und die Filterung der Dokumente übernehmen.
Sonstiges: Basiert auf den Informationen der Backend-API.
Vgl. eXist Solutions: eXist-db sowie Harris: Svelte. Cybernetically Enhanced Web Apps.↩︎
Die Bewertung der Übereinstimmung wird durch komplexe Mechanismen von Apache Lucene übernommen, welches als Grundlage für die Volltextsuche in eXist-DB dient.↩︎
Die Tokenisierung geht hier davon aus, dass einzelne Wörter durch Weißraum voneinander getrennt werden.↩︎